DATA SCIENCE / AI
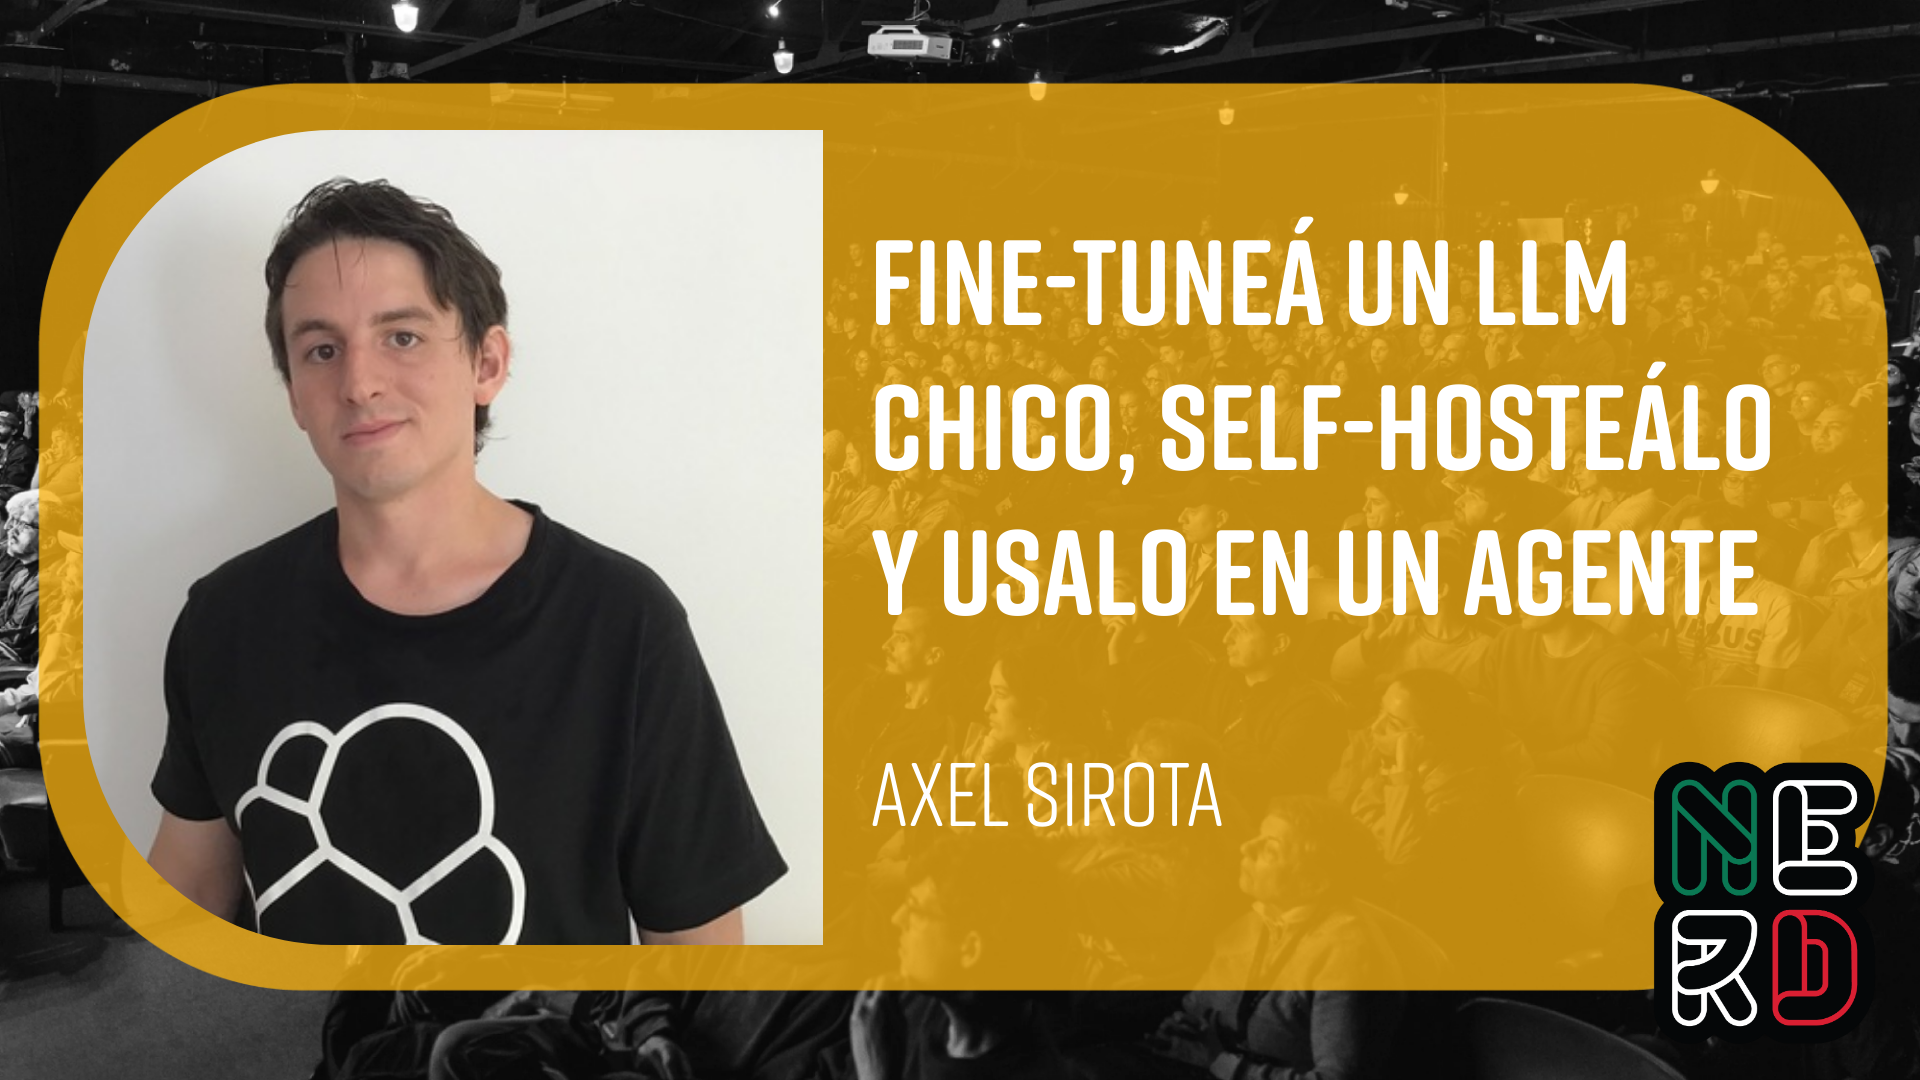
Fine-tuneá un LLM chico, self-hosteálo y usalo en un agente
¿Le pagás a una API gigante para una tarea chica, repetitiva y siempre igual? Hay otra opción: entrenar un modelo chico, tuyo y experto en ESO, y hostearlo vos.
En este taller, paso a paso y en vivo, fine-tuneamos un LLM chico con QLoRA en Colab (GPU T4 gratis), lo self-hosteamos y construimos un agente que lo usa como herramienta. La idea: un modelo especializado, barato y privado, que tu agente llama cuando le conviene, en vez de mandar todo afuera.
Agenda:
El problema: por qué no mandar TODO a una API gigante (7 min)
Lab 1 - PEFT en vivo: LoRA/QLoRA sobre un modelo chico en Colab T4 (15 min)
Lab 2 - Self-hosting: del adapter (~100 MB) al modelo servido (Ollama/vLLM) (13 min)
Lab 3 - El agente: exponemos tu modelo como herramienta y que lo use cuando conviene (15 min)
¿Cuándo fine-tunear vs solo promptear? costos, privacidad y template (6 min) + Q&A (4 min)
Te vas a llevar tres cosas: un notebook que fine-tunea un LLM con QLoRA y te deja un adapter chiquito (MB, no GB); tu modelo experto self-hosted y servido, sin depender de una API externa; y un agente que lo usa como herramienta, con el criterio de cuándo conviene fine-tunear.
Regístrate para ver el taller de Axel Sirota
Regístrate gratisMás de DATA SCIENCE / AI
14:40 - 15:20
Instrumenting Agentic Systems With OTel GenAI Semantic Conventions
 Wolfgang Therrien
DATA SCIENCE / AI
Escenario verde
EN
Presenta
10:50 - 11:30
Del prompt al producto: Lo que nadie te dice sobre los costos ocultos de escalar IA en producción.
 Lorena Bravo
Codexmaxxing: ya no es tu computadora
 Victor Nunez
Hook your LLM to the real world: building an MCP server from scratch
 Frédéric Harper