DATA SCIENCE / AI
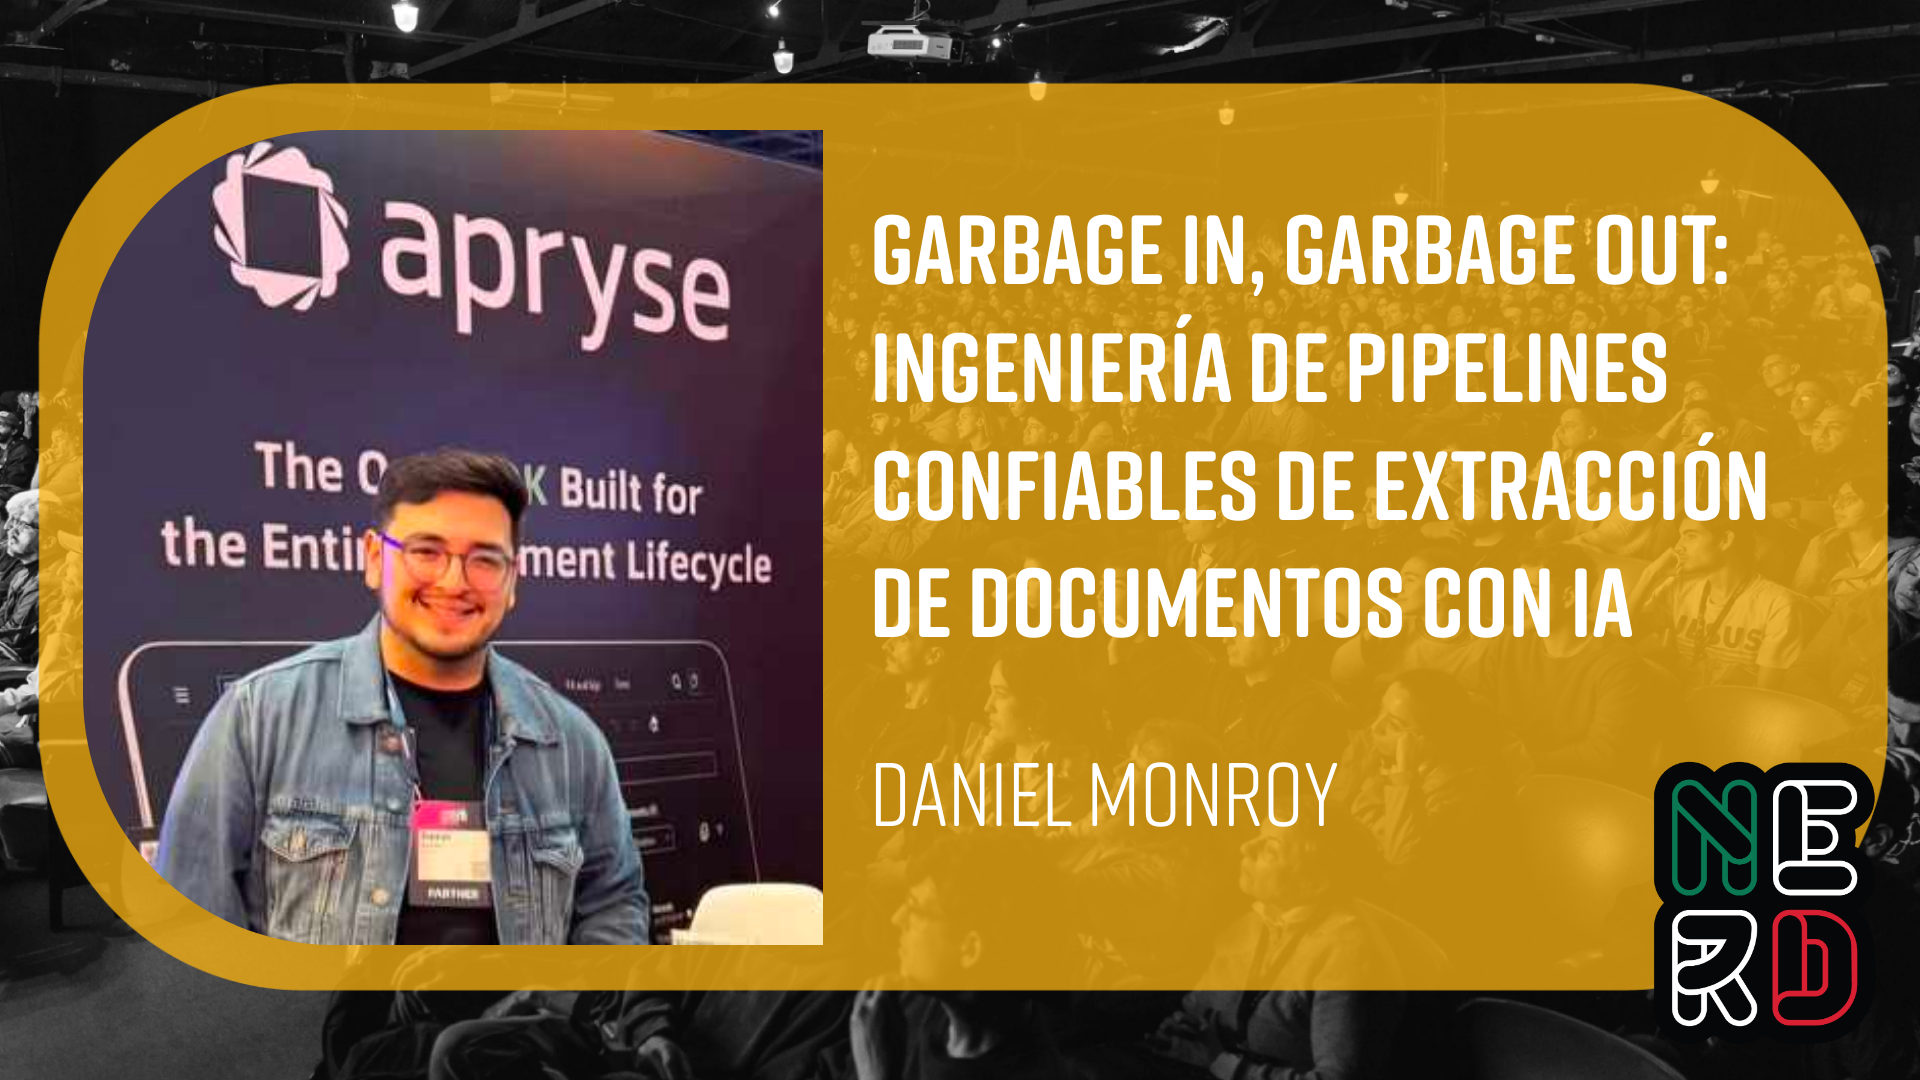
Garbage In, Garbage Out: Ingeniería de pipelines confiables de extracción de documentos con IA
Tu problema de OCR en realidad no es un problema de OCR: es un problema del pipeline. La mayoría de los pipelines de IA para documentos no fallan por el modelo, sino por los datos de entrada. Cuando le mandás a tus LLMs imágenes borrosas, malos recortes o texto sin estructurar, el resultado son costos elevados, pérdida de contexto y resultados impredecibles. En esta sesión, recorreremos un pipeline real de extracción de documentos de extremo a extremo (end-to-end) y mostraremos cómo garantizar la calidad de imagen en la captura, extraer datos estructurados en lugar de texto plano, y enviar payloads más livianos e inteligentes a los LLMs.
Regístrate para ver la charla de Daniel Monroy
Regístrate gratis
Esta charla la presenta
Más de DATA SCIENCE / AI
10:15 - 11:15
De Confluence a una LLM Wiki: Ingeniería de conocimiento con workflows agnósticos
 Eduardo Camacho
Hook your LLM to the real world: building an MCP server from scratch
 Frédéric Harper
Data Governance a AI Governance: de gobernar tablas a gobernar agentes
 Nora Butzmann
DATA SCIENCE / AI
Escenario verde
Presenta
17:20 - 18:00
Codexmaxxing: ya no es tu computadora
 Victor Nunez